很多文章在介绍 MLA(Multi-head Latent Attention)时,会说它是把 压缩到一个低维空间,需要时再还原回去。这个说法概括了缓存形式,但没有抓住要点。如果低秩投影就是核心思想,那 GQA 早就在做了:减少 头数后,只要 的总维度小于输入维度,从输入到 的映射本身就是降维。为什么还需要 MLA?
苏神在他的解析文章1中给出了一个 insight:MLA 的本质改进不是低秩投影,而是用可学习投影替代 GQA 的分割和复制,让每个头从同一个低维 latent 向量中提取出不同的 ,在低缓存开销下达到接近 MHA 的多头表达能力。
本文从一个思想实验出发2:如果我们不缓存 ,而是缓存更小的输入 会怎样?这个过程会自然地引出矩阵吸收和降维的思路。
如果你对 Attention 的基本原理还不熟悉,建议先阅读《为什么 KV 缓存没有 Q》。
出发点:KV Cache 太大了
KV Cache 的本质是用空间换时间。在自回归生成的 Decode 阶段,每生成一个新 token,都需要用当前的 去和历史所有位置的 做注意力计算。不缓存就要把每一层的历史 token 全部重算一遍;缓存则要把每一层、每一个头、每一个历史 token 的 向量全部存下来。注意,缓存节省的不仅仅是 Attention 的计算量,还包括 FFN 在内的整个 layer。
问题在于,缓存省下了重复计算,却增加了显存占用和读取量,Decode 往往受限于显存容量和带宽:
- 显存容量瓶颈:KV Cache 的总量随 batch size 和序列长度线性增长,很快超过模型参数本身的存储占用。
- 带宽瓶颈:Decode 阶段每步只算一个 token,算术强度极低,GPU 的计算单元大量空转在等待数据搬运。
- 互相制约:为了提高算力利用率想增大 batch size,又会进一步加剧显存压力。
模型参数在整个 batch 间共享,加大 batch 可以有效摊薄参数读取的带宽成本。但 KV Cache 是每个请求独立的:batch 翻倍,KV Cache 的总读取量也翻倍。对于使用 BF16 的常规 MHA,长序列 Decode 的 Attention 算术强度(arithmetic intensity)约为 1 FLOP/Byte3,通常受显存带宽限制。减小 KV Cache,既能容纳更多请求,也能减少每步生成的读取量。
MQA 和 GQA 试图通过让多个 头共享同一组 来缓解这个问题。它们确实有效,但都是在”保留 KV Cache”这一范式内做优化。MLA 则换了一个思路:不缓存 。
思想实验:缓存 X 而非 KV
在进入 MLA 的实际设计之前,我们先做一个思想实验。它不等同于 MLA,但展示了 MLA 背后的核心思路:可以不缓存 ,而是缓存更小的东西。
一个等价变换
设输入 的长度为 ,输入维度为 ,头数为 ,单头维度为 。在标准的 MHA 中(暂不考虑位置编码,省略 scaling factor 和 mask,只看单个头),、、,经过输出投影后的结果为:
的行对应 token 位置,列对应特征。Attention 涉及两个轴:位置选择和特征映射。位置轴上, 描述 token 之间的匹配关系,决定每个位置从哪些历史读取信息。特征轴上,、 共同决定读取哪些特征信息,以及如何映射为对残差流的更新4。
代入后:
转置 。应用矩阵乘法的结合律,得到:
这些权重既可以预先合并,也可以保留为独立矩阵,按吸收后的顺序分步计算。对于 ,原来先用 把 投影成 ,再与 做内积。吸收后,先让 乘 ,再与 做内积。
对于 ,两种顺序使用相同的注意力权重。位置轴上的线性组合与特征轴上的线性投影可以交换顺序,因此可以让 softmax 的结果先乘 ,再执行 ,无需先生成 。
这样就无需先生成 和 两个中间矩阵,计算结果保持不变。由此,只需要缓存每一层的输入 ,所有头共用这一份输入,替代各头展开后的 和 。
两种等价的计算路径,不同的计算量
这个等价变换给出了两种计算路径:从 显式生成 后计算 Attention,或通过矩阵吸收直接使用 计算。前者需要对整段 做 投影,后者将这些投影改为作用于本次 和输出。两条路径得到相同的结果,计算量却可能不同。
以只缓存 的单步 Decode 为例,用 表示当前 token 的输入,, 表示它对可见序列的注意力权重。以下按完整矩阵乘法统计单头 FLOPs,忽略 softmax 等运算。
显式生成 :计算 ,从整段 生成 ,再计算 、 和输出投影:
矩阵吸收:计算 和 ,再计算 、,最后执行 和 :
吸收后, 相关的投影只处理 和它对应的输出,开销由 降为 。Attention 计算量则由 增至 (通常有 )。因此序列较长时,矩阵吸收的收益更明显。而在无前缀缓存的整段 Prefill 中,两种顺序的投影都处理 个位置,就没有上述投影开销的节省,但 Attention 计算量仍然增长。总的来说,矩阵吸收的计算收益,取决于本次 的数量与可见 长度的关系。
缓存收益与计算代价
自回归生成会反复使用历史位置的 。常规 MHA 将它们存入 KV Cache,后续步骤直接读取,可以省去重复的投影计算。缓存 则保留投影前的输入,通过矩阵吸收完成计算。两种方案在单步 Decode 中的开销分别为:
MHA(缓存 ):只计算当前 token 的 ,历史 从 KV Cache 读取:
矩阵吸收(缓存 ):计算当前 ,直接使用缓存的 完成 Attention 和后续投影:
两种方案的投影部分计算量相同,Attention 的单头维度从 变为 。整段 Prefill 中也有同样的差别:投影开销均为 ,Attention 开销分别为 和 。由于通常 ,吸收形式需要更多计算。
以 DeepSeek-V3(,,)为例,与常规 MHA 相比:
- 缓存:KV Cache 每层每 token 缓存 维,缓存 只需 维,压缩 倍。
- 计算:吸收后,每个头的计算维度从 128 变为 7168,头数仍是 128。因此,无论按单头还是全部头统计,Attention 计算量都变为原来的 倍。投影部分不变。
缓存压缩 4.57 倍,吸收形式的 Attention 计算量却变为 56 倍。这是以额外计算换取更少的缓存读取量,但即使只在 Decode 使用吸收形式,这个交换仍不够理想。
对 X 降维
缓存大小和吸收后的 Attention 计算量都取决于 。如果能降低参与计算的向量维度,就能同时改善这两项代价。
比如用矩阵 把 的特征维度降到 :
和 改为从 生成。各头有自己的 ,共享降维矩阵 。将两步连起来就是 、。这种分解使所有头的 联合投影形成低秩参数化,各投影通过训练共同学习5。
代入 Attention 并应用矩阵吸收:
吸收前,每个头的 仍是 维。吸收后, 与 都是 维。因此,相比直接使用 ,每个头的 Attention 计算维度从 降到了 。每个 token 只需经 投影一次,生成的 由所有头共享。后续生成也只需缓存这份 ,每个 token 占 维。
以 DeepSeek-V3 的设置():
- 缓存量:,相比传统 KV Cache 压缩 64 倍(此前是 倍)。
- 计算量:Attention 计算量变为常规 MHA 的 倍(此前是 倍)。
缓存压缩 64 倍,吸收形式的 Attention 计算量只变为 4 倍。 相比直接缓存 ,这个取舍改善了很多。
共享 latent 与各头独立投影的组合,已经对应了 MLA 不带 RoPE 的计算结构。接下来把这套推导与论文中的符号和完整设计对齐。
从思想实验到实际 MLA
先把符号对齐
从这里开始,沿用 DeepSeek-V2 论文的符号和列向量约定: 表示当前层第 个 token 的输入。对应前面思想实验的 (行向量),则 ,对应的投影矩阵也是原来的转置。
论文将投影名称写成上标,例如 、。D 表示 down-projection,U 表示 up-projection,、 等标明投影对应的对象。下标 表示注意力头。 分别是整体投影中属于第 个头的行块, 是输出投影 对应该头的列块。
上标 表示不带 RoPE 的内容部分,先按下不表。
| 思想实验(单头、行向量) | 实际 MLA(列向量) | 对应关系 |
|---|---|---|
| , 共享 latent 向量 | ||
| 对应实验中该头的 | ||
| 对应实验中该头的 | ||
| 也通过降维、升维两步生成 |
这里, 经两组独立的投影分别生成 和 ,两者各自跨头共享。 的压缩用于缩减 KV Cache, 的压缩用于减少训练时的激活显存5。
可学习投影替代分割和复制
GQA 通过减少 的组数来缩减缓存:每组缓存一份 ,组内各 头直接共用。将各组缓存拼在一起看,各头按组取用的方式就相当于分割和复制,同组 头只能使用相同的 。
思想实验展示了另一种做法:缓存共享的 latent,再通过各头独立的投影生成不同的 。MLA 中的 就承担这个作用,以可学习投影替代分割和复制,让各头的 由各自的参数决定。
MLA 与常规 MHA 的计算路径对比如下6:
| 计算路径 | MHA | MLA(暂不含 RoPE) |
|---|---|---|
| , | ||
| , | ||
| 复用同一个 , | ||
| Decode 缓存 | 各头的 | 所有头共享的 |

以 DeepSeek-V3 参数为例7,,,, 压缩维度 , 压缩维度 :
上式中的 ,是所有头的总维度。 和 将 512 维的 latent 向量升到这个总维度,再按头拆分为 128 份,每份 128 维。
注:单层 MLA 中参数量最大的矩阵是输出投影 ,约 1.17 亿。它将所有头拼接后的结果映射回 hidden size 8。
矩阵吸收:MLA 的两种计算顺序
上面的计算先从 latent 向量生成各头的 ,再执行 Attention。应用思想实验中的矩阵吸收,可以调整这些投影的执行顺序。DeepSeek-V2 附录 C 写道5:
Fortunately, due to the associative law of matrix multiplication, we can absorb into , and into .
将各 token 的列向量并排组成矩阵,用 表示跨头共享的 latent, 表示第 个头的内容。两种形式均使用 。以下省略缩放与 mask,softmax 沿可见的 位置计算。
非吸收形式先展开该头的 :
吸收形式调整投影顺序,直接使用 :
对于 ,原来对 做投影以生成 ,现在对 做投影,得到 后直接与 计算 Attention。对于 ,原来先生成 ,现在先计算 ,再执行 和 。
各头用自己的 组合共享的 ,再经 生成各自对残差流的更新。各头的贡献 相加得到 ,虽然共享同一份缓存,但各头仍有自己的位置选择和特征映射。。
DeepSeek-V3.2 附录 A 将非吸收形式称为 MHA mode:Attention 使用各头独立的 ,换取较低维的 Attention。吸收形式称为 MQA mode:多个 头直接使用共享的 ,直接在 latent 上计算,Attention 的 head 只有一份9。
MHA mode 与 MQA mode 是同一个 MLA 的两种等价执行形式,不是两种表达能力不同的模型。 它们使用同一组权重,得到相同的 ,改变的只是中间表示与计算量。
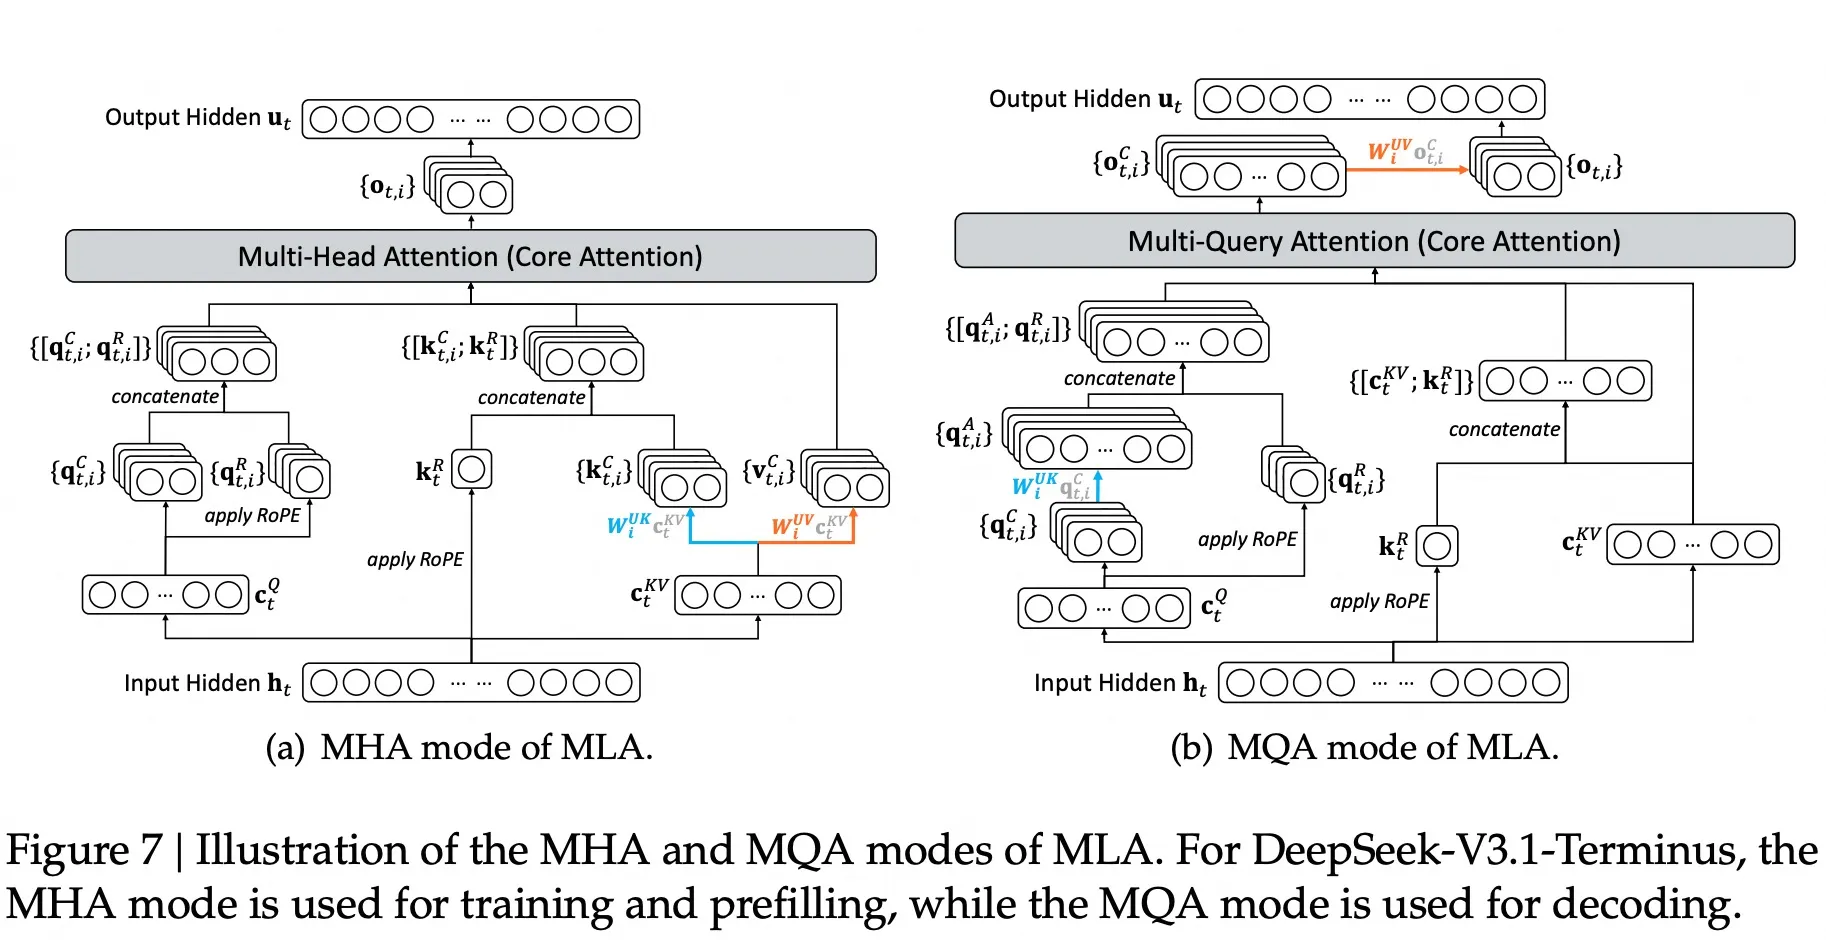
蓝色、橙色箭头分别标出 、 在两种计算顺序中的位置。图中 对应本文 的第 列。右图蓝色箭头未标出转置,按列向量约定应为 。RoPE 部分在后文展开。
上图表述:DeepSeek-V3.1-Terminus 在训练和 Prefill 时使用 MHA mode,在 Decode 时使用 MQA mode9。两种模式仍可保留相同的 latent 缓存,MHA mode 展开的 只用于本次 Attention 计算。
| 内容 | MHA mode | MQA mode |
|---|---|---|
| ,128 维 | ,512 维 | |
| 各头独立的 ,各 128 维 | 共享 ,512 维 | |
| Attention 输出 | ,每头 128 维 | ,每头 512 维 |
| 后续投影 | 、 |
设本次 长度为 ,可见 长度为 。沿用思想实验的单头 FLOPs 口径,两种模式均从 latent 计算,省略相同的投影与 softmax 等运算:
MHA mode:
MQA mode:
将两式相减,就能看出切换到 MQA mode 时省下的投影与增加的 Attention 计算量:
投影只处理本次 个位置,省下了已有缓存中 个位置的投影。Attention 仍处理 个位置对,但计算维度从 增至 。前者超过后者时,差值为正,MQA mode 的总计算量更少。
无前缀缓存的整段 Prefill 中,,没有投影收益,MHA mode 在 时更省计算。单步 Decode 中,,序列较长时投影收益超过 Attention 代价,因而 MQA mode 更省计算。
带前缀缓存或分块 Prefill 时,前缀越长并不一定越适合 MQA mode。代入 DeepSeek-V3 的参数,按已有缓存长度 整理差值:
固定本次输入长度 ,当 时,增加前缀长度能提高吸收收益,但前缀足够长才会使差值为正。当 时, 的系数为负,无论前缀多长,MHA mode 都更省计算。
在执行吸收形式时,DeepSeek-V3 官方参考实现保留独立权重,分步完成投影。输出计算中,各头经 投影后拼接,再执行整体 8。相比预先合并成稠密矩阵,保留小矩阵更节省权重存储和投影计算。
压缩限制了什么
普通 MHA 的每个头通过 提取 维特征。即使经 映射回 维,乘积矩阵 的秩仍不超过 10:
以 DeepSeek-V3 为例,虽然单个头最多只能表达 128 个独立方向,但 可以学习这 128 个方向在 7168 维输出空间中的具体取向。各头不仅能写入不同的子空间,还能使用不同的注意力权重,因此 Attention 整体的表达能力不受限于单头的秩。
MLA 额外增加了来自 latent 压缩的约束。 的整体投影经过共享的 维表示, 则经过 维表示:
相对的,常规 MHA 的整体 投影秩上限为 。沿用 DeepSeek-V3 的参数,MLA 的 秩上限为 512, 为 1536,而 MHA 的秩上限为 7168。
由于 ,latent 压缩不会进一步降低单头 投影的秩上限,却降低了所有头合起来的整体投影秩上限。各头的 都只能从同一个 512 维子空间中提取信息,独立投影无法取回 latent 压缩过程中丢失的信息。
矩阵吸收只重排已有投影,不改变这些约束。以吸收后的等效 投影为例,它的秩仍受单头 的 维限制:
因此, 虽然有 512 维,却仍处于至多 128 维的子空间中。输出投影同理,吸收前后的秩上限均由单头维度决定。
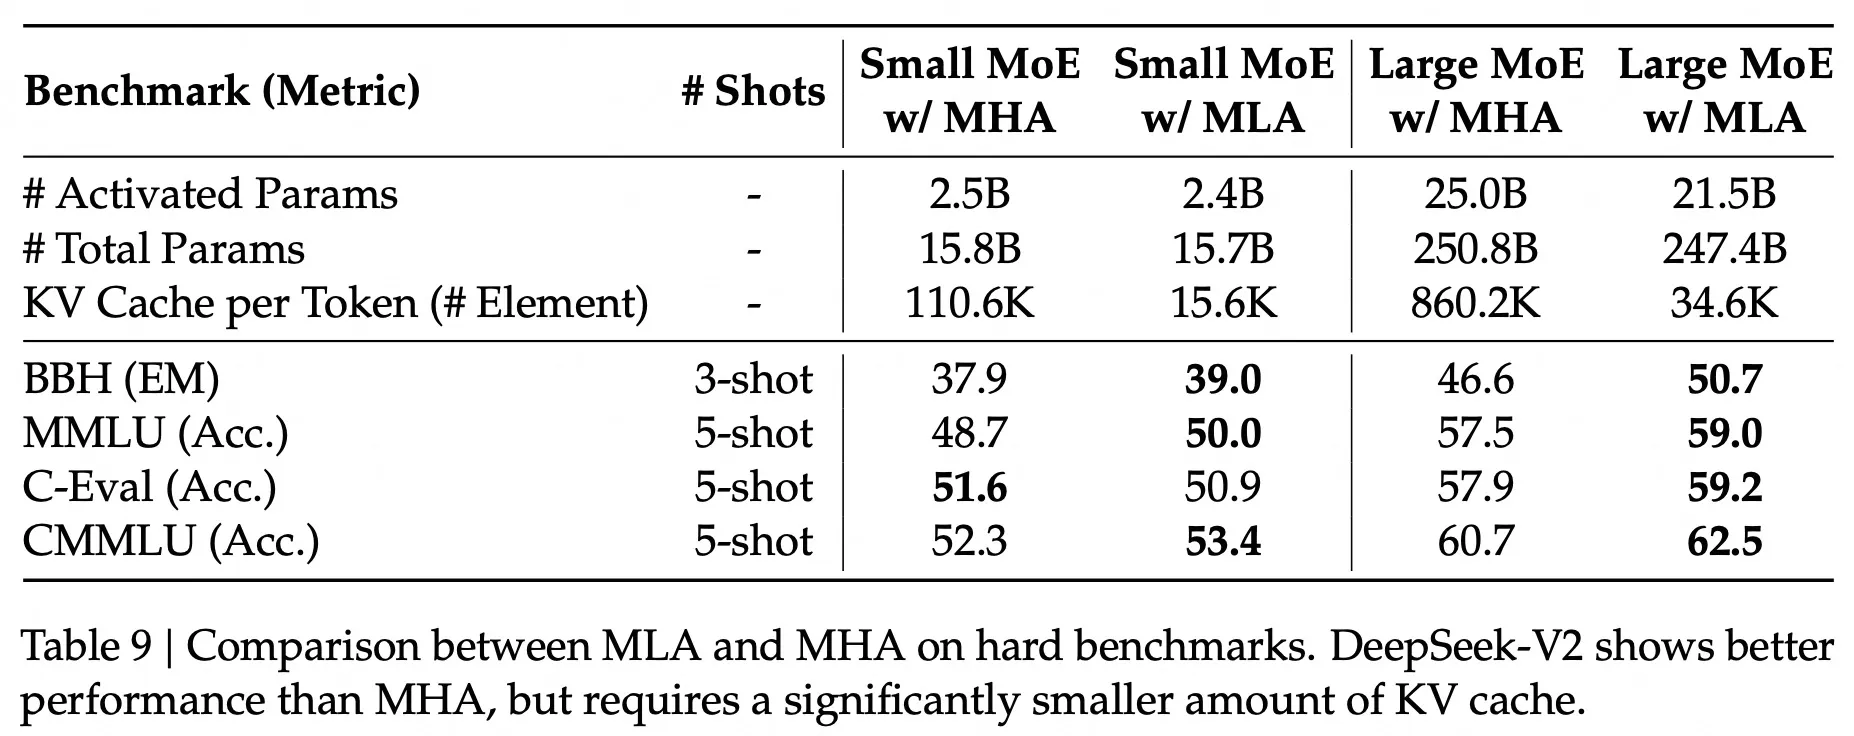
输入方向的减少是否影响任务效果,要看 latent 保留了什么信息。MLA 的降维和升维投影共同训练,让有限的 latent 维度用于任务所需的信息。下图的两种规模 MoE 对照实验中,MLA 总体优于 MHA5,说明低秩参数化可以形成有效的模型架构。论文尚未明确这一优势的来源,判断压缩是否合算仍需比较任务效果与缓存、计算代价,不能只比较秩上限。
为什么让 共享 latent
MLA 的 latent 不仅跨头共享,还必须同时满足生成 的需要。如果分别使用两个 维 latent,两个投影可以选择不同的输入方向,各自的秩不超过 ,联合秩却可能达到 。共享 latent 则要求两者合起来也只能使用 个独立输入方向。将 与 按行拼接,可得:
以 DeepSeek-V3 的维度为例,假如 latent 不是 KV 共享,两个独立的 512 维 latent 允许联合秩达到 1024,共享后的上限则固定为 512,同时 latent 缓存减半。但共享还带来了通信收益:在 MQA mode 中,加载到片上的 可以供多个头复用,并同时用于 ,减少重复的显存读取11。
这些收益需要付出多少效果代价,可以参考直接共享 投影的实验。将两者绑定为同一矩阵后,缓存减半,测试集 PPL 仅从 60.7 升至 61.212。另一组对照中,约 300M 和 1.2B 规模模型的验证集 PPL 分别增加 3.1% 和 2.48%13。这些实验为共享的合理性提供了支持:在所测设置下,取消独立表示带来的效果损失较小。
Gemma 4 也在部分全局 Attention 层复用 投影作为 ,采用了类似的共享思路14。不过区别是 MLA 是通过共享降维投影 ,保留独立的 来保留灵活度,不要求 。但两者的思路都是让同一份信息通过不同映射参与 Attention,在减少存储的同时保留两种表示的差异。
RoPE 兼容性:一个精巧的折中
前面的推导暂未考虑位置编码。加入 RoPE15 后, 和 的计算会随位置变化,矩阵吸收也因此受到限制。
矩阵吸收的前提是: 可以合并为一个与位置无关的固定矩阵。但如果 RoPE 对位置 的 和位置 的 分别施加旋转矩阵 ,就会得到:
中间插入了一个与相对位置 相关的旋转,两个投影无法再被合并为固定矩阵。如果只缓存 ,沿用显式恢复 的路径,就必须对所有历史位置重新计算带 RoPE 的 ,失去了矩阵吸收省下的计算收益。
DeepSeek 的解法是一种混合方案:每个头的 、 被拆成两部分拼接,一部分不加 RoPE(走矩阵吸收路线),另一部分加 RoPE。位置编码部分用上标 表示,特征维度为 。将层输入按列排列为 ,用 表示沿特征维拼接,RoPE 对各列按其位置旋转:
从层输入生成,所有头共享; 从 经各头独立投影生成,各头不同。

图中为未吸收形式。斜线标记的 latent KV 与 RoPE 需要缓存,RoPE 由当前输入生成。
RoPE 部分保持上述计算方式,内容部分应用矩阵吸收,注意力权重为:
最终缓存 和 ,每层每 token 合计 个元素,BF16 下为 1152 Bytes。固定这两个维度后,增加头数不会增加这份逻辑缓存。

设 GQA 有 组,令其缓存量 ,得到 :MLA 的逻辑缓存相当于 2.25 组 GQA。值得指出的是,TP 并行开启的情况下各 rank 通常会冗余存储 latent KV 和 RoPE 8。
结语
回到开头的问题:MLA 到底做了什么?
MLA 重新定义了”该缓存什么”。 MQA 和 GQA 在 KV Cache 内部做取舍,减少 头数,用表达能力换存储。MLA 则换了个思路:缓存所有头共享的 latent 向量 ,通过各头可学习的投影生成不同的 。矩阵吸收又将这些投影改为作用于 和输出,使模型可以直接使用 latent 计算,省去历史 的重建。DeepSeek-V2 的消融实验表明,这种设计在减少缓存的同时,仍能取得接近 MHA、在部分基准上优于 MHA 的效果。
整个设计用到的数学工具都是线性代数的基本操作:结合律、低秩投影、恒等变换。真正的巧妙在于把这些简单组件组合成了一个系统,在计算能力和显存带宽间的 trade-off 里找到了一个此前不存在的平衡点。
如果希望进一步了解工程实现、源码级细节,推荐阅读16。
附录:为什么说 GQA 是”分割和复制”
正文中提到”GQA 采用的是分割和复制”,这是苏神提出的一个视角,把 GQA 和 MLA 放进同一个”压缩→恢复”的统一框架中比较。
常规的理解是:GQA 减少 头数, 个 头分成 组,每组复用同一份 。但苏神指出,如果把 GQA 所有组的 拼成一个向量:
这个 的维度是 ( 和 的维度均取 )。当 时, 本身就是一个低秩投影,只不过投影矩阵恰好是各组投影的拼接。
接下来,GQA 从 恢复每个头的 的方式是:分割(按组切片取出对应的 、)+ 复制(同组内的 个 头共用这份 )。
而 MLA 把这一步换成了每个头独立的可学习投影 ,自由度高得多。从这个视角看,GQA 和 MLA 的区别不在于是否做低秩投影,而在于从低维向量中恢复 per-head 的机制:分割复制 vs 可学习投影。
参考资料
-
苏剑林, 缓存与效果的极限拉扯:从MHA、MQA、GQA到MLA, 2024. kexue.fm/archives/10091 ↩
-
Sholto Douglas, Anselm Levskaya et al., Scaling Book: Inference, 2025. jax-ml.github.io/scaling-book/inference ↩
-
Nelson Elhage et al., A Mathematical Framework for Transformer Circuits, 2021. Attention Heads are Independent and Additive、Attention Heads as Information Movement。 ↩
-
DeepSeek-AI, DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model, 2024. arXiv:2405.04434 ↩ ↩2 ↩3 ↩4
-
kaiyuan, 超细图解MLA计算流&吸收矩阵对比分析。参考其并排展示结构与执行流程的方式,以及按 Query 长度、缓存长度比较计算量的方法。 ↩
-
DeepSeek-AI, DeepSeek-V3 Technical Report, §2.1、§4.2. arXiv:2412.19437。本文沿用 V2 的 MLA 符号,以 V3 的维度参数举例。 ↩
-
DeepSeek-AI, DeepSeek-V3 官方推理实现:
MLA类。naive与absorb两种实现展示了不同的执行顺序。absorb在每个 TP rank 上保存完整的 latent 与 RoPE 。 ↩ ↩2 ↩3 -
DeepSeek-AI, DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models, 2025. arXiv:2512.02556。附录 A 的 Figure 7 对比 MLA 的 MHA / MQA mode,并说明 DeepSeek-V3.1-Terminus 在训练、Prefill 和 Decode 中的模式选择。 ↩ ↩2
-
五道口纳什,MHA 的 QKVO 四重投影,为什么少不了 W_O?,Bilibili 视频。 ↩
-
Ted Zadouri, Hubert Strauss, Tri Dao, Hardware-Efficient Attention for Fast Decoding, 2025. §3.2 分析 MLA 如何通过跨头复用 latent,以及让 共用同一份数据,提高算术强度。 ↩
-
Kazuki Irie et al., How Much Self-Attention Do We Need? Trading Attention for Feed-Forward Layers, ICASSP 2020. §5.2、Table 4。正文引用 TED-LIUM 2 上的 32 层语言模型实验,对照保持层数与 FFN 配置一致,共享后参数量随之减少。 ↩
-
Ali Kayyam et al., Do Transformers Need Three Projections? Systematic Study of QKV Variants, 2026,预印本。§4.3、Tables 4、9。模型从头训练,使用 10B tokens。该实验比较独立投影与直接共享投影,并非 MLA 共享 latent 与独立 latent 的对照。 ↩
-
Gemma Team, Gemma 4 Technical Report, 2026. §2。除 E2B、E4B 外的模型在全局 Attention 层复用 作为 ,并配合 p-RoPE。 ↩
-
苏剑林, Transformer升级之路:2、博采众长的旋转式位置编码, 2021. kexue.fm/archives/8265 ↩
-
罗西的思考, 探秘Transformer系列之(28)--- DeepSeek MLA, 2025. 博客园——覆盖了矩阵吸收、RoPE 解耦、源码实现和 MHA。 ↩